序
过去谈 AI 编程,很多时候指的是代码补全:输入几行代码,工具补出一个函数;选中一段逻辑,工具帮忙解释、重构或生成测试。这类能力已经改变了日常开发,但它解决的主要还是“这一段代码怎么写”。
当任务变成“为一个已有服务增加幂等能力,并完成测试、迁移、审查和交付”时,问题就不再只是生成代码。Agent 需要理解项目规则,找到相关模块,选择合适的工具,在隔离环境中修改文件,运行测试,根据错误继续修复,并在结束前留下可检查的结果。
这也解释了为什么模型能力之外,还需要一套工程化的支撑系统:上下文从哪里来,工具允许做什么,代码在哪里运行,结果如何验证,失败后怎样恢复,整个过程如何审计。模型负责提出下一步动作,Harness 负责让这些动作在真实软件环境中安全、可控地执行。
本文先回顾 AI 编程从代码模型、Copilot 到 Coding Agent 的演进,再说明 Harness 的组成和主流实践,最后通过一个项目的端到端实践 Demo,展示它如何与项目规范、OpenSpec、Superpowers、测试和 CI 结合,形成一条可复用的开发流程。
1. 🧭 AI 编程走到哪一步了
AI 编程大致经过了几个阶段:
| 阶段 | 主要能力 | 常见评价指标 |
|---|---|---|
| 规则系统 | 按人工规则检查代码、生成模板 | 规则覆盖率、误报率 |
| 机器学习 | 缺陷预测、代码分类、API 推荐 | Accuracy、Precision、Recall |
| 深度学习代码模型 | 学习代码的语法和结构,完成补全与翻译 | 编译率、Exact Match、BLEU |
| 大语言模型 | 根据自然语言生成函数、类、脚本和测试 | Pass@k、测试通过率 |
| Copilot | 结合 IDE 上下文,实时补全、解释和重构 | 采纳率、编辑时间、人工修改量 |
| Coding Agent | 读取仓库、修改多个文件、运行命令和测试 | 任务成功率、Patch 正确率、回归率 |
| Harness Engineering | 让 Agent 在真实环境中持续、可控、可验证地完成任务 | 端到端成功率、恢复率、成本、人工介入率 |
Transformer 让模型更适合处理长序列和大规模训练,成为后续代码大模型的基础。Attention Is All You Need
早期代码模型解决的是“补全这一段代码”。现在的 Coding Agent 处理的是一个完整任务:
理解需求 → 搜索仓库 → 制定计划 → 修改文件 → 运行测试 → 根据错误继续修复
这也是 Harness 出现的背景:模型本身只会生成下一步文本,真正让它能够工作的是外部的运行时、工具和反馈系统。

2. 🧰 Harness 是什么
Harness 直译为“挽具”或“支架”。在传统软件工程中,test harness 指负责准备环境、执行被测程序、收集输出和判断结果的测试支架。
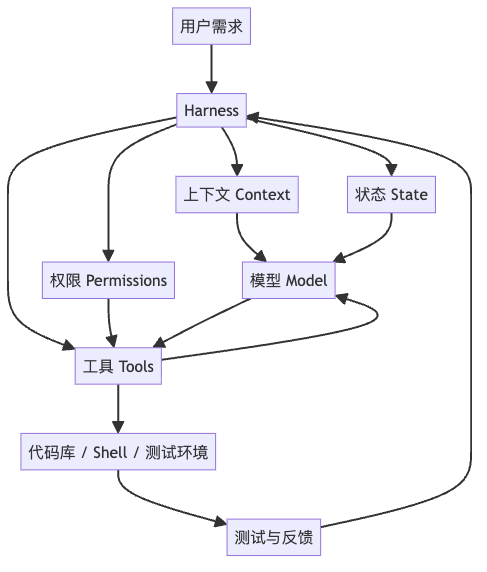
在 AI 编程中,Agent Harness 指包围在模型外面的运行时和控制层。它负责把模型接到代码库和执行环境上,并管理整个任务生命周期。
可以简单表示为:
Agent = Model + Harness + Tools + Environment + Feedback
- Model:理解需求、规划步骤、生成动作;
- Harness:构建上下文、调用工具、保存状态、控制循环和权限;
- Tools:文件系统、Shell、Git、测试、浏览器、数据库、LSP、MCP;
- Environment:本地工作区、容器、远程开发机或 CI;
- Feedback:编译错误、测试结果、日志、静态分析和人工审查。
因此,Harness 不是一个单独的模型,也不等同于 Prompt。它是模型周围那套让任务真正跑起来的工程系统。Cloudflare 将其概括为负责模型调用、Prompt 构建、工具选择、记忆、生命周期和继续/停止判断的循环。Cloudflare Agents Harnesses
3. 谁提出了 Harness
这个问题需要分开回答:
- Harness 这个词并非 AI 时代产生。软件测试、编译器测试和系统测试很早就使用 test harness。
- Agent Harness 是近年来 Agent 框架逐渐形成的共同抽象,没有一个得到行业普遍承认的唯一发明者。
- Harness Engineering 作为近期 AI 编程工作方法的命名,较早被公开使用的是 Mitchell Hashimoto 在 2026 年 2 月 5 日发表的文章《My AI Adoption Journey》。他的核心观点是:Agent 每犯一次可重复的错误,就把解决方案固化到规则、工具或环境中,避免它下次再犯。My AI Adoption Journey
所以更准确的说法是:Hashimoto 命名并推广了 Harness Engineering 这种实践,但不是 Harness 概念的唯一提出者。随后 OpenAI、Anthropic、Microsoft、Cloudflare 和 Thoughtworks 等团队从 Agent Runtime、长任务、工具编排和上下文工程等角度继续完善这个概念。
4. 🧩 Harness 的主要组成
4.1 任务规格:把需求变成验收条件
Agent 最怕目标含糊。Harness 或任务模板应明确:
- 要解决什么问题;
- 可以修改哪些目录;
- 不允许改变什么;
- 如何运行测试;
- 什么条件下算完成。
例如,不要只写“修复订单重复创建”,而应写成:
相同 idempotency_key 只能创建一次订单;
不改变现有 API 返回结构;
补充并发测试;
现有测试和新增测试全部通过。
这些内容通常称为 Task Specification、Acceptance Criteria 和 Definition of Done。
4.2 上下文工程:给 Agent 足够但不混乱的信息
Harness 需要从仓库中选择相关信息,而不是把所有文件一次性塞进上下文窗口。常见来源包括:
README、架构文档和开发规范;AGENTS.md、CLAUDE.md等项目指令文件;- 相关源文件和测试文件;
- AST、LSP 和代码索引;
- Git 历史、当前 diff、Issue 和 PR;
- 上一轮命令的错误输出。
这里涉及 Context Engineering、Repository Understanding、RAG、Context Compression 和 Context Window Management。实践中,相关性通常比上下文总量更重要。
4.3 工具层:让模型能行动
最小工具集通常包括:
search_code(query)
read_file(path)
apply_patch(diff)
run_command(command)
run_tests(target)
git_diff()
工具应有清晰的名称、严格的参数 Schema、稳定的返回格式和明确的错误信息。把所有能力塞进一个 execute_anything(command),虽然实现简单,但不利于权限控制、审计和模型正确调用。
大型系统还会接入:
- LSP:获取类型、定义、引用和诊断信息;
- MCP:以标准协议提供外部工具和数据;
- Browser Automation:启动应用并验证页面流程;
- Git Integration:查看 diff、创建分支和生成 PR;
- CI Integration:运行构建、测试和安全扫描。
4.4 Agent Loop:模型、工具和反馈的循环
Harness 的核心不是一次模型调用,而是一个受控循环:
Plan → Act → Observe → Verify → Repair → Finish
简化伪代码如下:
for step in range(MAX_STEPS):
    context = build_context(state)
    action = model.decide(context, tools=tools)

    if action.type == "tool_call":
        result = execute_tool_safely(action)
        state.append(action, result)
        continue

    if action.type == "final":
        result = verify()
        if result.passed:
            return report_success(state)
        state.append(result)

return report_failure(state)
常见控制模式包括 ReAct、Retry Loop、Repair Loop、Reflection、Handoff 和 Human-in-the-loop。必须设置最大步数、超时时间和重试次数,避免 Agent 无限循环。
4.5 ⚠️ 执行环境与权限
Agent 需要执行代码,但不能默认拥有整台机器的全部权限。常见隔离方式包括:
- Docker 或 Dev Container;
- 独立 Git Worktree;
- 远程 Sandbox;
- 文件和网络 Allowlist;
- Secret Isolation;
- 高风险操作的 Approval Gate;
- 任务级 Kill Switch。
典型的高风险操作包括删除目录、修改 Git 历史、访问生产数据库、读取密钥和向外部系统发送请求。OpenAI 对 Agent Sandbox 的描述中,也把 Harness 视为负责工具路由、审批、追踪、恢复和运行状态的控制平面。OpenAI:Sandbox Agents
4.6 ✅ 验证层:不要让模型自己判定完成
模型说“已经修复”不等于任务完成。Harness 应调用外部验证器:
- Unit Test:单元测试;
- Integration Test:集成测试;
- End-to-End Test:端到端测试;
- Type Checking:类型检查;
- Linting:代码规范检查;
- Build Verification:构建验证;
- Security Scan:安全扫描;
- Human Review:人工审查。
更可靠的工作流是:
先复现 → 写失败测试 → 修改代码 → 运行测试 → 分析失败 → 继续修复
SWE-bench 将评价对象从孤立代码片段提升为真实仓库中的 Issue 修复,这也说明测试环境和验证流程会直接影响 Agent 的表现。SWE-bench 相关研究
4.7 状态、记忆和恢复
长任务可能跨越多个上下文窗口,因此 Harness 需要保存:
- 当前目标和计划;
- 已完成步骤;
- 失败尝试和错误原因;
- 测试结果;
- 当前分支和工作区状态;
- Checkpoint 和中间产物。
这对应 Session State、Working Memory、Persistent Memory、Checkpoint、Resume 和 Context Compaction。状态保存得好,Agent 才能在暂停后继续,而不是每次从头猜测。
4.8 可观测性
至少应记录:
- 模型请求和响应;
- Tool Call 与 Tool Result;
- 文件修改和 Git diff;
- 测试结果;
- Token、耗时和成本;
- 重试次数;
- 权限审批;
- 最终状态。
没有 Tracing、Logging 和 Metrics,就很难判断失败来自模型、上下文、工具、环境还是测试本身。
5. 🛠️ 主流实践
5.1 IDE Agent
Agent 运行在 IDE 中,能够搜索项目、编辑文件、执行测试并根据错误继续修改。适合交互式开发、局部重构和前端调试。GitHub Copilot Agent 就采用了这种模式。GitHub Copilot Agents
5.2 Terminal-native Agent
Agent 直接运行在终端、开发容器或远程工作区中,拥有更完整的 Shell、Git 和测试能力。适合后端项目、多文件修改、复杂调试和自动化脚本。
5.3 Background Agent
用户提交 Issue,Agent 在隔离环境中异步工作,最后返回分支、Commit 或 Pull Request。依赖升级、批量迁移、补测试和文档更新比较适合这种方式。
5.4 Multi-Agent
常见分工是:
Planner → Coder → Tester → Reviewer
多 Agent 能提高并行度,但会增加状态同步、修改冲突、Token 成本和审计难度。一个工具和验证设计良好的单 Agent,往往比多个互相转发消息的 Agent 更稳定。
5.5 仓库规则文件
把项目规则写入仓库是成本最低、收益较稳定的 Harness 实践。内容通常包括:
- 目录结构和模块边界;
- 安装依赖和运行测试的命令;
- 代码风格和提交规范;
- 不允许修改的文件;
- 常见错误及处理方式;
- 完成任务前必须执行的检查。
Hashimoto 所说的 Harness Engineering,核心就是把一次性的人工纠正沉淀为规则、脚本、工具和验证流程,使同一个错误不再反复出现。
6. 📦 当前可用的产品与开源组件
6.1 成熟产品
下面这些产品已经把“读代码、改文件、执行命令、运行测试、查看 diff”做成了可直接使用的 Coding Agent。它们的差别主要在交互方式、模型来源、部署位置和自动化程度。
| 产品 | 形态 | 适合场景 | Harness 特点 |
|---|---|---|---|
| Claude Code | 终端 Agent | 后端开发、调试、重构 | 终端、文件、Shell、Git、MCP,适合长任务 |
| OpenAI Codex | CLI、IDE、云端 | 多文件修改、代码审查、后台任务 | 沙箱、权限控制、测试和任务状态 |
| GitHub Copilot coding agent | GitHub / IDE | Issue 到 Pull Request | 和仓库、Issue、PR、CI 集成较紧密 |
| Cursor Agent | IDE、CLI、云端 | 日常开发、重构、前端调试 | 代码库搜索、多文件编辑、终端、计划模式 |
| Trae | AI 原生 IDE | 国内团队的日常开发、代码库问答和 Agent 任务 | IDE、项目上下文、Agent 窗口和自动化工作流 |
| 通义灵码 | IDE 插件、AI IDE | Java、Web 和企业应用开发 | 代码补全、问答、代码库理解和智能体能力 |
| Gemini CLI | 开源终端 Agent | 终端开发、脚本和自动化 | Apache-2.0,支持 MCP 和 Gemini 模型 |
选型时,不必只比较模型排行榜。更应该比较能否访问真实代码库和测试环境、能否配置项目规则和自定义工具、能否限制 Shell 与网络权限,以及是否保留 diff、日志和任务状态。
6.2 开源 Agent 与运行时
如果要自建 Coding Harness,可以从以下项目开始:
| 项目 | 类型 | 主要用途 |
|---|---|---|
| OpenHands | 开源 Agent 平台 / SDK | 代码编辑、Shell、浏览器、沙箱和 Agent 扩展 |
| SWE-agent | 开源代码修复 Agent | 从 GitHub Issue 出发,生成补丁并运行验证 |
| Aider | 开源终端编程工具 | 轻量的仓库级对话编程、代码编辑和 Git 提交 |
| OpenCode | 开源终端 Coding Agent | 可替换模型和工具,适合本地化终端工作流 |
| Gemini CLI | 开源 Coding Agent | 可直接使用,也可作为终端 Agent 的实现参考 |
这些项目适合研究 Agent Loop、工具接口、上下文组织、权限控制和终端交互。正式使用前应单独确认项目的许可证、依赖和安全边界。
6.3 自建 Harness 的基础组件
实际项目通常不是从零写一个完整 Agent,而是按层组合组件:
| 层次 | 常用组件 | 解决的问题 |
|---|---|---|
| 工具协议 | MCP | 统一暴露工具、资源和外部系统 |
| Agent 编排 | LangGraph、OpenAI Agents SDK、Microsoft Agent Framework | Agent Loop、状态、Handoff、Guardrails、Tracing |
| 代码 Agent 基础 | OpenHands SDK、SWE-agent | 文件、Shell、代码修复和任务执行 |
| 代码执行沙箱 | E2B、Daytona | 隔离运行 AI 生成的代码和开发环境 |
| 代码理解 | LSP、Tree-sitter、语言编译器、ripgrep | 符号、类型、引用、语法和代码检索 |
| 验证与评测 | pytest、JUnit、Playwright、Semgrep、SWE-bench | 测试、静态检查、安全扫描和任务评测 |
| 可观测性 | OpenTelemetry、Agent SDK Tracing、结构化日志 | 记录模型调用、工具调用、耗时、成本和失败原因 |
MCP 解决“Agent 如何连接外部工具”,LangGraph 等框架解决“多个步骤如何编排和恢复”,E2B 或 Daytona 解决“代码在哪里安全执行”。三者不是互相替代的产品。
6.4 三种落地组合
个人开发:
Claude Code / Codex / Cursor
+ AGENTS.md
+ Git
+ 本地测试命令
团队内部 Agent:
OpenHands 或自定义 Agent
+ MCP
+ LangGraph / Agents SDK
+ Docker 或 Daytona Sandbox
+ CI、代码审查和审计日志
批量 Issue 修复或评测:
SWE-agent / OpenHands
+ 标准化代码仓库环境
+ SWE-bench 类任务集
+ 独立测试容器
+ 结果记录和失败轨迹分析
产品适合直接验证流程,开源组件适合控制模型、工具、部署和数据。常见做法是先用成熟产品验证工作流,再把稳定部分下沉为自有 Harness。
7. 🚀 一个项目的端到端实践 Demo
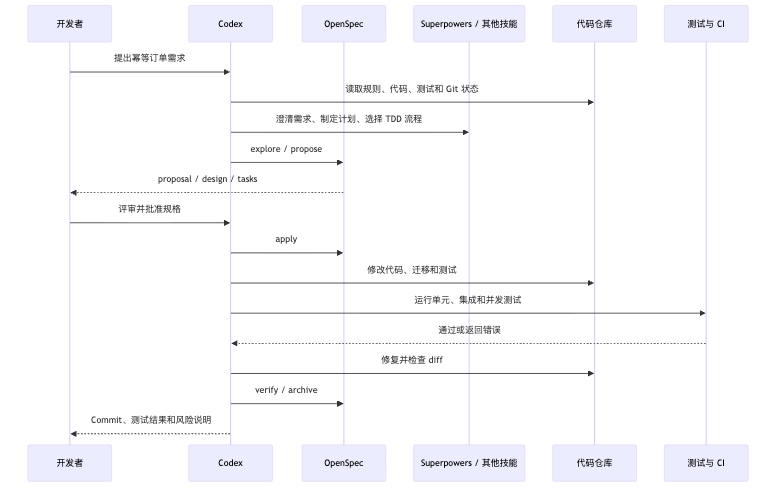
下面用一个已有的 Spring Boot 电商订单服务做 Demo。需求是:为 POST /orders 增加幂等创建能力。客户端传入 Idempotency-Key,同一个 Key 重复提交时只能创建一个订单,后续请求返回第一次创建的结果;同时不改变已有响应结构,并增加并发测试。
这类需求需要同时处理接口、事务、数据库约束、并发、测试和兼容性,适合用来说明 Harness 如何参与一次完整开发。
7.1 工具和技能分工
| 工具或技能 | 在本例中的职责 |
|---|---|
| Codex | 读取仓库、调用工具、修改代码、运行命令、根据反馈继续修复 |
| OpenSpec | 固化需求、设计、场景和任务清单 |
| Superpowers | 约束工作方式:先澄清、再计划、TDD、分任务实现、逐步审查 |
| Java / Spring 技能 | 遵循项目分层、事务、异常和测试约定 |
| Database Migration 技能 | 检查 Flyway/Liquibase 迁移和索引设计 |
| Security Review 技能 | 检查重放、越权、日志泄露和敏感信息问题 |
| CI / Test 技能 | 执行单元、集成、并发、构建和静态检查 |
这里的“技能”不是模型能力,而是可加载的工作流说明、脚本和参考资料。Codex 的技能通常以带有 SKILL.md 的目录存在,AGENTS.md 则提供仓库级长期约定。OpenAI Docs:Skills
Superpowers 也是一组可组合的 Agent Skills 和软件开发方法:先澄清需求并形成设计,再制定计划,采用 TDD,按任务实现并进行审查。obra/superpowers
7.2 AGENTS.md:把项目经验写进 Harness
先说明命名:Codex 通常读取仓库级的 AGENTS.md;本文使用这个标准名称。当前仓库里的 Agent.md 是项目自定义的工作规范,不能默认当作所有 Coding Agent 都会读取的规则文件。为了兼容不同工具,可以保留 Agent.md,再增加一个 AGENTS.md,或者在 AGENTS.md 中明确引用它。
根目录的 AGENTS.md 不需要写成百科全书,重点是让新成员和 Agent 知道“项目怎么跑、哪些事情不能做、完成前必须检查什么”。例如:
# Order Service Agent Guide

## 项目

- 这是一个 Spring Boot 订单服务。
- 订单创建入口:`OrderController`
- 订单业务编排:`OrderApplicationService`
- 数据访问:`OrderRepository`
- 数据库迁移:`db/migration/`,使用 Flyway。

## 开发命令

```bash
./gradlew test                 # 单元测试
./gradlew integrationTest     # 集成测试,需要 Docker
./gradlew check                # 完整质量检查
```

## 规则

- 先阅读 OpenSpec 变更,再修改业务代码。
- 修改数据库必须新增 Flyway migration,不得直接改历史 migration。
- Controller 不写业务逻辑,事务边界放在 Application Service。
- 不在日志中打印 Token、支付信息或完整的 Idempotency-Key。
- 不要覆盖用户已有的未提交修改。
- 不要为了完成当前需求重构无关模块。

## 完成条件

- 新增行为有测试;
- `./gradlew clean test` 通过;
- 相关集成测试通过;
- `git diff --check` 通过;
- 最终输出修改文件、测试命令、测试结果和已知风险。
在订单模块下,还可以放更具体的 src/main/java/com/example/order/AGENTS.md:
# Order Module Rules

- 订单状态只能通过 `OrderStateMachine` 变更。
- 创建订单必须使用 `OrderApplicationService` 的事务方法。
- 幂等键的唯一性由数据库约束保证,分布式锁只能作为优化,不能作为最终一致性依据。
- 捕获唯一键冲突后必须查询已有订单,并返回符合 API 契约的结果。
- 并发行为必须使用真实数据库集成测试验证,不能只用 Mockito 验证。
目录级规则让 Agent 在进入订单模块时自动获得更窄的上下文。规则、脚本和技能组合起来,才是可维护的 Harness;单独写一段很长的 Prompt,无法替代这些可复用的项目约定。
7.3 先检查仓库,不直接写代码
先让 Codex 做只读检查:
请先阅读仓库根目录的 AGENTS.md 和项目文档。
检查 git status、构建命令、测试命令、数据库迁移方式和当前订单创建流程。
只做分析,不要修改文件。输出相关模块、调用链、现有测试、影响范围和验证命令。
Codex 可能会执行:
git status --short
./gradlew test
rg "createOrder|OrderController|OrderRepository|idempotency" src db
如果工作区已有未提交修改,应先停止并提示用户;高风险任务则从独立 Git Worktree 开始。这个步骤避免 Agent 把旧改动当成自己的工作,也避免它在不了解项目命令时直接修改代码。
7.4 用 Superpowers 澄清需求
触发 using-superpowers 和 brainstorming 类技能后,Codex 先确认:
- 幂等键由哪个客户端生成;
- Key 的有效期和存储周期;
- 重复请求是否返回完全相同的响应;
- 第一次请求失败时能否重试;
- 不同用户使用同一个 Key 是否拒绝;
- 并发控制由数据库唯一约束还是分布式锁完成。
然后把需求收敛为可测试的场景:
同一个用户用 Key=abc 提交相同订单 4 次,只生成一个订单,4 次返回同一结果。
两个请求同时使用同一个 Key 时,数据库中只能存在一个订单。
第一次请求因支付服务失败时,重试行为符合约定,不能产生重复订单。
7.5 用 OpenSpec 形成实现规格
OpenSpec 将需求拆成 proposal、spec、design 和 tasks,并提供 explore、propose、apply、verify、archive 等阶段。OpenSpec
在 Codex 中先执行:
/opsx:explore
分析订单创建链路、事务边界、订单表结构、异常处理和测试方式。
重点回答:幂等记录放在哪一层,唯一约束如何设计,哪些代码不能复用。
不要修改业务代码。
探索完成后:
/opsx:propose add-order-idempotency
生成 proposal.md、specs/、design.md 和 tasks.md。
必须包含接口契约、状态转换、数据库变更、并发行为、失败重试策略和测试验收条件。
设计文件至少应明确:
1. orders 表增加 idempotency_key,并建立合适的唯一约束;
2. 订单创建和幂等记录在同一事务内完成;
3. 唯一键冲突时查询已有订单,不返回无意义的 500;
4. 日志不打印完整的 Idempotency-Key;
5. 测试覆盖正常、重复、并发、失败重试和跨用户场景。
这一步把“我想要幂等”变成 Agent 可以逐条核对的工程合同。Codex 的计划和技能也适合保存为仓库内的长期产物,而不是只留在聊天记录里。OpenAI Cookbook:Iterating Development Workflows with Codex
7.6 人工评审规格
开发者先审阅 OpenSpec 产物,再允许 Agent 写代码。重点检查:
- 唯一索引是否符合真实业务键;
- 事务边界是否覆盖订单和幂等记录;
- 支付调用是否错误地放进数据库事务;
- 旧客户端没有 Header 时是否保持兼容;
- 返回第一次结果是否会泄露其他用户订单。
如果规格不对,先修改 design.md 和 tasks.md,不要让 Agent 在错误设计上继续实现。
7.7 用 Superpowers + TDD 分任务实现
规格通过后执行:
/opsx:apply add-order-idempotency
按 tasks.md 逐项实现。每项先补测试,再运行最小范围测试,检查 git diff。
不要跳过失败测试,也不要顺手重构无关模块。
任务可以拆成:
Task 1:增加数据库迁移和唯一索引
Task 2:增加幂等记录模型和 Repository
Task 3:修改 Application Service 的事务逻辑
Task 4:增加重复请求测试
Task 5:增加并发集成测试
Task 6:更新接口文档和监控指标
每项都走同一个反馈回路:
Codex 修改代码 → Gradle 测试 → 错误输出回到 Codex → 修复 → 再测试
测试失败时,应把完整命令、断言和相关日志交给 Agent,而不是只说“再试一次”。这样才能区分代码错误、环境问题和规格遗漏。
7.8 独立验证、审查和交付
实现完成后执行:
/opsx:verify add-order-idempotency
再进行只读代码审查:
检查并发下是否可能创建两个订单、唯一键冲突是否正确转换、事务边界是否合理,
是否有日志或接口兼容性回归,以及测试是否覆盖并发和失败重试。只输出问题清单,不修改代码。
最后运行:
./gradlew clean test
./gradlew integrationTest
./gradlew check
验证通过后归档变更:
/opsx:archive add-order-idempotency
交付物不应只有代码,还应包括 OpenSpec 产物、数据库迁移、测试命令、风险说明、Git diff 和 Commit。这个例子中:OpenSpec 管“要做什么”,Superpowers 管“怎么按工程方法做”,Codex 负责“在仓库中执行”,测试和 Review 负责“判断是否完成”。
7.9 新成员如何按同一套流程工作
新成员不需要先读完整个代码库,也不需要自己猜团队习惯。进入项目后的第一件事,是让 Harness 输出当前阶段和下一步动作:
我是订单服务项目的新成员。请按照仓库的 AGENTS.md、OpenSpec 和已安装技能引导我完成一次功能开发。
先不要修改代码,告诉我当前 Harness 阶段、需要阅读的文件、需要确认的问题和下一条命令。
统一流程可以固定为:
| 阶段 | Agent 的动作 | 新成员需要做什么 | 产物或出口条件 |
|---|---|---|---|
| 1. Bootstrap | 读取 AGENTS.md、检查工具和 Git 状态 |
确认项目目录和权限 | 环境检查报告 |
| 2. Explore | 搜索调用链、测试、配置和依赖 | 回答业务澄清问题 | 问题清单、现状说明 |
| 3. Specify | 执行 OpenSpec explore/propose | 审阅 proposal、design、tasks | 获得规格批准 |
| 4. Plan | 使用 Superpowers 拆分步骤和测试 | 确认任务边界 | 可执行任务清单 |
| 5. Implement | 按任务修改代码并运行最小测试 | 处理需要人工决策的分歧 | 代码、测试和迁移 |
| 6. Verify | 运行测试、静态检查、安全审查和 diff 检查 | 审阅问题清单 | 所有验收条件满足 |
| 7. Deliver | 生成 Commit、PR 和变更记录 | 做最终 Review | 可合并的交付物 |
每一阶段都应该有明确的“进入条件”和“退出条件”。例如,没有完成 Explore,就不进入 Specify;没有批准 design.md,就不进入 Implement;没有通过 Verify,就不能进入 Deliver。这样新成员遵循的是项目流程,而不是某个资深开发者的个人习惯。
建议在仓库中保存一个统一入口,例如 docs/ai-development-workflow.md:
# AI 功能开发入口

1. 读取 `AGENTS.md` 和目标模块下的规则文件。
2. 执行 `/opsx:explore <问题>`,只读分析代码库。
3. 执行 `/opsx:propose <change-name>`,生成并评审规格。
4. 使用 Superpowers 的计划和 TDD 技能拆分任务。
5. 执行 `/opsx:apply <change-name>`,逐项实现并测试。
6. 执行 `/opsx:verify <change-name>`,完成独立验证和审查。
7. 修复所有阻塞问题后执行 `/opsx:archive <change-name>`。
8. 提交代码、测试结果、风险和变更说明。
以后无论是新员工、外包成员,还是另一个 Coding Agent,都从同一个入口开始。Harness 的价值就在这里:把项目知识和开发方法从“口头传承”变成可读取、可执行、可检查的工作流。
8. 📏 如何评价一个 Harness
除了模型能力,还应关注 Harness 本身:
| 指标 | 关注点 |
|---|---|
| Task Success Rate | 任务是否真正完成 |
| Test Pass Rate | 补丁是否通过测试 |
| Regression Rate | 是否破坏原有功能 |
| Recovery Rate | 遇到失败能否继续修复 |
| Human Intervention Rate | 需要人工接管的比例 |
| Time / Token / Cost | 完成任务的时间和成本 |
| Security Violation Rate | 是否越权或执行危险操作 |
| Reproducibility | 相同条件下结果是否稳定 |
评测时应同时披露模型、Prompt、工具、上下文策略、测试环境、权限范围和循环上限。只公布一个分数,无法判断结果来自模型还是 Harness。
9. 🎯 结语
AI 编程已经从“生成代码片段”进入“在代码库中完成任务”的阶段。Harness 解决的不是模型知识问题,而是工程问题:
给它什么上下文?
允许它做什么?
如何让它运行?
如何验证结果?
失败后如何恢复?
如何审计整个过程?
可以这样区分:
Prompt Engineering:让模型回答得更好。
Harness Engineering:让模型在真实软件环境中可靠地完成任务。
未来 AI 编程的竞争,不只取决于模型,也取决于上下文、工具、环境、验证、权限、状态和可观测性这些工程环节。
参考资料
- Attention Is All You Need
- Cloudflare Agents: Harnesses
- VS Code: Agent Harnesses
- OpenAI: Sandbox Agents
- GitHub Copilot Agents
- Mitchell Hashimoto: My AI Adoption Journey
- Thoughtworks / Martin Fowler: Harness Engineering
- SWE-bench 相关研究
- Model Context Protocol
- OpenHands
- SWE-agent
- LangGraph
- OpenSpec
- obra/superpowers